Codex 搭 AI 知识库:LLM Wiki 加 Obsidian 一套流程

大模型处理文档,目前最主流的做法还是 RAG,也就是检索增强生成。上传一批文件,提问时系统先检索出相关片段,再让模型基于这些片段生成回答。Notebook LM、ChatGPT 的文件上传,以及大多数企业级知识库,走的都是这条路。它成熟好用,但代价藏在一个不太显眼的地方。

RAG 缺的是积累

每一次[……]

继续阅读

Codex 一句话处理飞书数据:接上飞书 CLI 就行

2026 年 3 月底,飞书把自己的 CLI 开源了。对一天大部分时间都泡在飞书里的团队来说,这件事的意义是多了一个入口。数据仍然留在这套结构里,不用导出,也不用手动翻页。在 Codex 里说一句话,就能把这些内容读出来,再顺手整理干净。下面把接入的完整路径走一遍,从装工具到跑通一个真实例子,中间容[……]

继续阅读

Codex 写完文章自动配图:Obsidian 里一套流程搞定

写文章最耗时间的环节之一就是配图。找图,裁图,插到对的位置,一篇下来能磨掉不少耐心。Obsidian 本身是本地优先的知识管理工具,加上 Codex 命令行能直接调用生图模型 gpt-image-2,配图这一步就能交出去。

前提有两样,会基本的 Obsidian 操作,以及熟悉 Codex 命令行的[……]

继续阅读

Codex 自己开浏览器查资料:接上 Playwright MCP 就行

改完前端代码想让 Codex 自己确认页面跑通了,光看代码它做不到。Playwright MCP 补的就是这一环。它是基于 Playwright 的 MCP 服务器。它把打开浏览器,访问网页,点击按钮,填写输入框这些操作封装成 AI 能调用的工具。读页面内容,截图,验证结果这几项也在里面。

装上之后[……]

继续阅读

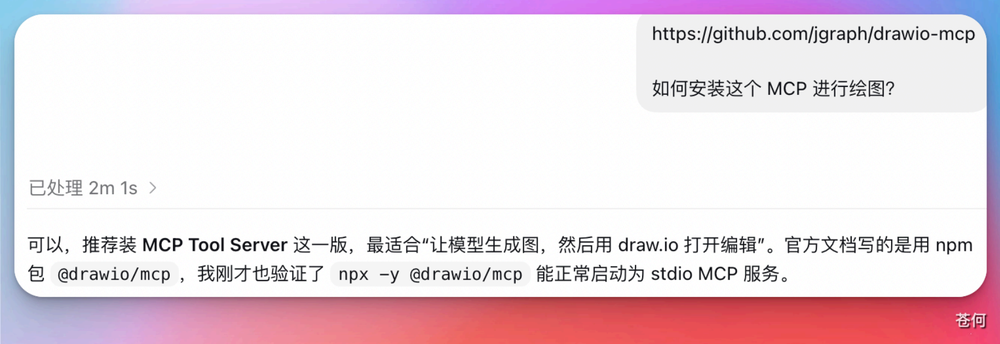
Codex 画架构图:接上 Draw.io MCP,AI 自己出图

介绍项目架构或者业务流程的时候,一段文字读者容易看累,一张图的理解成本低得多。Draw.io 本来就是画这类图的常用工具,官方发布自己的 MCP 之后,把它接进 Codex,画图这一步也能交出去。

它擅长画哪几类图

图类型典型用途流程图走一遍业务流程的先后顺序架构图讲清系统模块之间的关系思维导图把[……]

继续阅读

Codex 一句话生成 PPT:装上这个 Skill 就能用

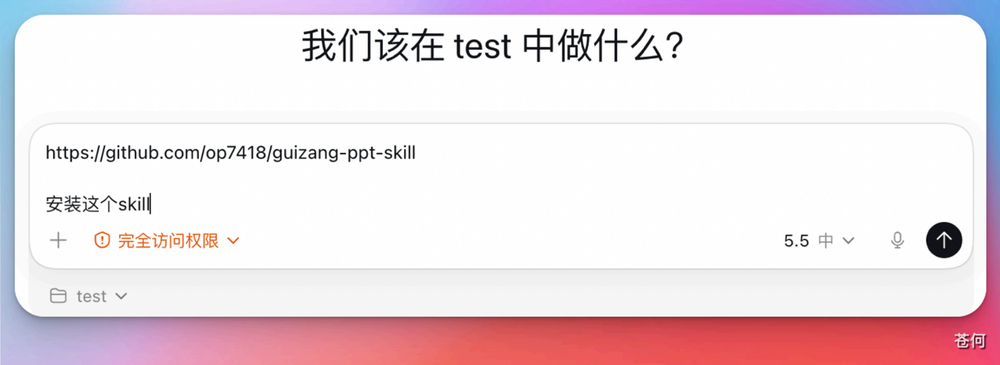
手上有现成的社区 Skill,装它却是件麻烦事。手动整理目录,放对位置,检查依赖,一套下来半小时就没了。把 Skill 的仓库地址交给 Codex,让它自己读仓库,判断依赖,完成安装。这件事就压缩成一句话。

第一步:让 Codex 装,别自己整理目录

社区里不少开发者会把自己做好的 Skill 放[……]

继续阅读

Codex 怎么带进团队用?AGENTS.md 管规则,PR 模板管留痕

一个人用 Codex,规则记在自己脑子里就够了。多个人一起用,规则就得写进仓库,否则每个人拿到的结果都不一样。团队接入的重点其实就三件事:规则写清楚,验证跑起来,案例沉淀下来。

先弄清权限是怎么组合出来的

团队里最容易吵起来的是它能干什么这个问题。这个答案由三样东西拼出来,都在配置项里。

配置项管什[……]

继续阅读

Codex 从需求到交付(下):提交、写 PR、复盘一条链收口

测试通过,审查也过了,这时候最容易松一口气说一句完成了。但真正的链路还差两步,把这次修改正式提交,把这次经验沉淀下来。

只做到代码能跑,短期看没问题,长期会出现一个麻烦。每次都像第一次做,重复的解释和重复的坑会一直在。

commit 要说明这次改了什么

commit 不是随便写一句 update 就[……]

继续阅读

Codex 从需求到交付(中):小步改、认真验,改动不失控

计划确认之后才动代码。最容易出问题的地方是一次性让它全部实现,页面和样式一起动。最后项目看起来变了,你却判断不出哪里出了岔子。更稳的方式是一次只改一个功能点,改完就检查一段。

一次只改一个功能点

比如优化首页,不要一次性说优化整个首页,可以拆成几步。

步骤修改内容第一步只优化首屏标题和副标题第二步只[……]
继续阅读