大模型处理文档,目前最主流的做法还是 RAG,也就是检索增强生成。上传一批文件,提问时系统先检索出相关片段,再让模型基于这些片段生成回答。Notebook LM、ChatGPT 的文件上传,以及大多数企业级知识库,走的都是这条路。它成熟好用,但代价藏在一个不太显眼的地方。
RAG 缺的是积累
每一次提问,模型都要从零开始重新发现知识。问一个需要综合五篇文档的问题,RAG 会检索,拼接,生成。第二天再问同样的问题,整个流程原样重来一遍,不留任何痕迹。
本来可以建立起来的知识关联,就在一次又一次的重复查询里被丢掉了。AI 领域的研究者 Andrej Karpathy 把这个现象点出来,并且给出了另一套思路,叫 LLM Wiki。
三层结构各管一件事
这套设想把系统分成三层。
最下面是原始资料层,放的是论文和文章,也包括播客和网页素材。模型对这一层只读不改。
中间是 Wiki 层,模型在这里拥有完整所有权。它负责编写 Markdown 文件和目录,也负责做摘要和抽实体概念。比较分析和综述,页面的创建和更新,交叉引用的维护,这些都由它来打理。人只需要读。
最上面是 Schema 层,本质是一份配置文件。对 Codex 来说就是 AGENTS.md,对 Cursor 来说就是 .cursorrules。它规定这个知识库的结构规范、命名约定和工作流程,用着用着两边一起迭代。
在 Obsidian 里把骨架立起来
先去找 Karpathy 公开的那份原始设计文档,他在一个 gist 里写清了整套设计理念,按关键词搜一下就能找到。
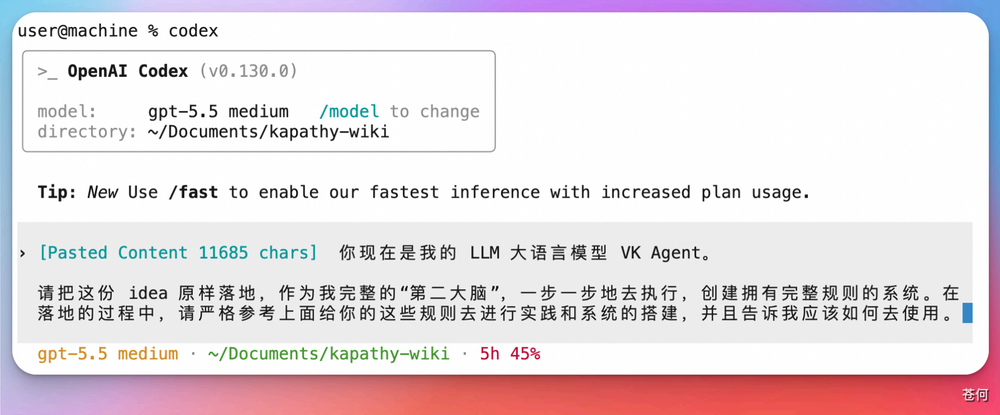
然后在本地新建一个 Obsidian 仓库,把下面这段提示词发给 Codex。内容大意是:你现在是我的 LLM Wiki Agent,请把这份 idea 文件原样落地,作为完整的第二大脑。要求一步一步执行,创建一套拥有完整规则的系统,落地过程严格参考那份原始仓库。
照着走完,仓库里会长出四个文件夹。名字分别是 concept、raw、logs 和 wiki。另外还有一个 AGENTS.md 和一个 log,也就是 Schema 层那份配置文件。这套目录结构跟 Karpathy 描述的 LLM Wiki 架构是对得上的。
一篇文章怎么进库
入库靠一个浏览器插件,Obsidian Web Clipper。它把浏览器里的文章和视频,连同网页正文,自动提取下来存进本地仓库,方便交给 Codex 拆分。
看到想收进知识库的文章,用插件把它保存到仓库的 raw 文件夹里。在 Karpathy 的设计里,raw 专门放未经处理的原始素材。在插件里点”添加到 Obsidian”,文件就落下来了。
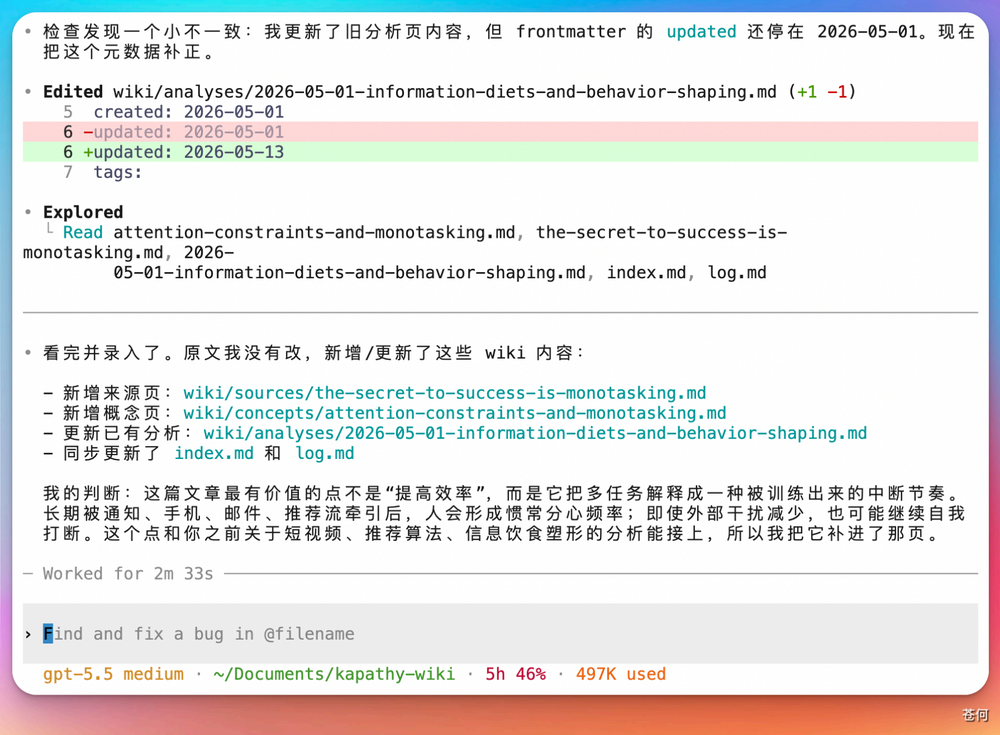
回到 Obsidian,让 Codex 读这一篇文章。它会自动通读内容,按 LLM Wiki 的理念拆开,新增摘要页,实体页和关联引用页面。做完之后它会告诉你具体加了哪些东西,到这一步这篇文章才算正式入库。
之后就是重复同一套动作
想研究同一个主题的更多材料,流程跟上面一样。用插件把新文章存进 raw,让 Codex 把它拆成多个 Wiki 页面,再让它更新相关文件的交叉引用。
内容攒得越多,知识之间的关联就越清楚,最后长成一个真正结构化的第二大脑。
