2026 年 3 月底,飞书把自己的 CLI 开源了。对一天大部分时间都泡在飞书里的团队来说,这件事的意义是多了一个入口。数据仍然留在这套结构里,不用导出,也不用手动翻页。在 Codex 里说一句话,就能把这些内容读出来,再顺手整理干净。下面把接入的完整路径走一遍,从装工具到跑通一个真实例子,中间容易卡住的地方也一并说清楚。
装 CLI 这件事可以交给 Codex 自己做
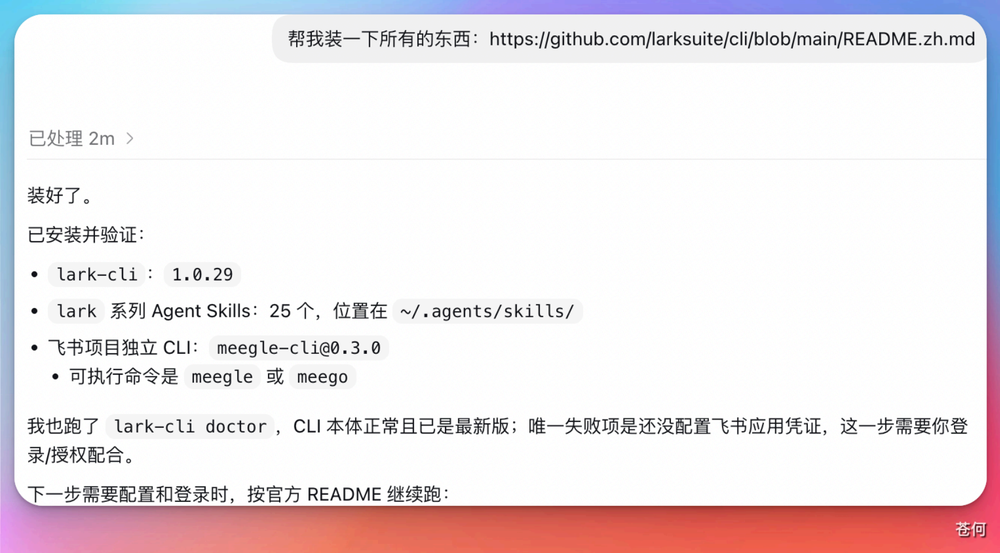
飞书 CLI 的安装细节不用自己啃。它的 GitHub 仓库里有一份中文版 README,把这份文档的地址直接丢给 Codex,让它把所有的东西装好,它会自己走完依赖和配置。
提示词可以很短,一句”帮我装一下所有的东西”,后面跟上 README 的地址就够了。Codex 会读文档,判断需要哪些步骤,然后逐个执行,装了什么也会回头告诉你。
凭证这关:App ID 和 App Secret 从哪来
飞书 CLI 要连你的飞书,得先有一个开放平台应用,也就是一对 App ID 和 App Secret。
卡点通常不在填写这一步,而在找不到建应用的地方。这一步同样可以直接问 Codex,它会给出飞书开放平台的地址,再引导你在浏览器里创建应用。
按指引建好之后,把 App ID 和 App Secret 发回给 Codex,它会自动完成应用配置和权限申请。凭证属于敏感信息,填的是你自己那一对值,别贴到公开的地方。
中间会穿插手动授权。Codex 会给出跳转链接,在浏览器里放行对应权限,它才拿得到读取和操作飞书数据的资格。授权这一步省不掉,权限范围看清楚再点确认。
跑起来是什么效果
配置完成之后,Codex 手里的飞书操作能力一下子就宽了。可以先让它列举一遍当前能访问哪些内容,把边界摸清楚。
它还会主动告诉你第一次该怎么用,连提示词都替你写好,照着发就行。这种细节对刚上手的人挺省事。
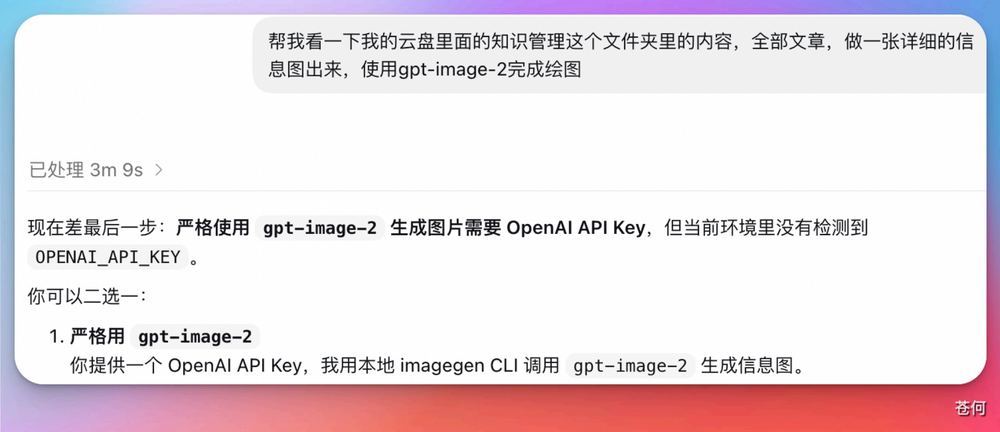
一个真实的例子是读云盘。让它去读飞书云盘里一个叫”知识管理”的文件夹,里面一共 14 篇文档,读完之后直接调用 GPT 最新的生图模型,产出一张中文信息图。从执行过程能看出云盘内容是完整读到了,访问链路是通的。
它开口要 API Key 的时候可以顶回去
走到生图那一步,它开口要求提供 OpenAI 的 API Key。
这里其实不合理。订阅了 Codex 和 ChatGPT Plus,在 Codex 里本来就能直接调用 GPT 的生图模型,不需要另外准备密钥。遇到这种情况直接反驳,说清楚不需要额外 API Key 就行。反驳之后它会正确调用 GPT-Image-2 生成信息图,全程没有多余的密钥要求。
模型给出的建议偶尔会偏保守,判断依据站不站得住,还是要靠使用者自己过一遍。
